0. 들어가며
PM: "여기에 관련 문서 모아 두었어요. 확인 부탁드립니다."
개발자가 기획을 전달받을 때 흔히 마주하는 장면입니다. 문서 링크가 담긴 메시지를 받으면 개발자는 그것을 다시 개발 요건으로 정리한 뒤에야 구현에 들어갑니다.
이 과정을 반복하다 보니 한 가지 의문이 들었습니다.
개발자: "기획 문서에 담긴 내용이 곧 만들고자 하는 서비스 로직인데, 꼭 매번 이렇게 다시 한 번 가공해야 할까?"
그래서 저희는 사내 AI week를 맞아 PM과 개발자가 처음부터 하나의 리포지토리를 함께 만드는 실험을 했습니다.
저희가 만든 것은 '가상 유저 패널'이라는 사내 툴입니다. PM도 에이전트와 함께 파일을 수정하고 커밋하며 개발에 참여한 툴입니다. 실험을 시작한 지 약 3개월 뒤, 리포지토리에 쌓인 커밋 중 약 30%는 PM이 에이전트와 함께 작성한 것이었고, PM은 담당 영역을 넘어 DB 스키마 추가나 UI 리팩터링(refactoring)과 같은 큰 작업도 해 볼 수 있었습니다.
이처럼 PM이 마음 놓고 개발하고 커밋하려면, 리포지토리는 무엇을 해 줘야 했을까요?
이 글에서는 다음 내용을 다룹니다.
- PM이 관리하는 파일을 서비스 코드와 분리하고, 변경 사항을 테스트·린트·CI로 검사하는 방법(2. PM과 개발자가 함께 수정할 수 있는 리포지토리).
- PM이 올린 UI 리팩터링·DB 테이블 추가 PR을 개발자가 리뷰하고 머지한 과정(2-4. 실제 변경에서 드러난 자동 검사와 리뷰의 역할).
- 다른 팀에서 같은 구조를 만들 때의 작업 순서(3. 다른 팀에 적용한다면).
1. 가상 유저 패널
삼쩜삼에는 유저 리서치 데이터가 꾸준히 쌓이고 있었지만, 새 아이디어나 시안을 만드는 중에 바로 쓰기는 어려웠습니다. 자료가 곳곳에 흩어져 있어 PM과 디자이너는 문서를 찾아 읽으며 눈앞의 시안에 유저가 어떻게 반응할지를 머릿속으로 예상해야 했습니다.
그래서 저희는 시안이나 아이디어를 올리면 바로 반응을 볼 수 있는 '가상 유저 패널'을 만들었습니다([그림 1]). Figma 링크·스크린샷·설명 등을 올리면 가상 유저의 피드백을 받을 수 있습니다. 웹 UI뿐 아니라 CLI와 MCP 서버에서도 같은 패널을 호출할 수 있습니다.
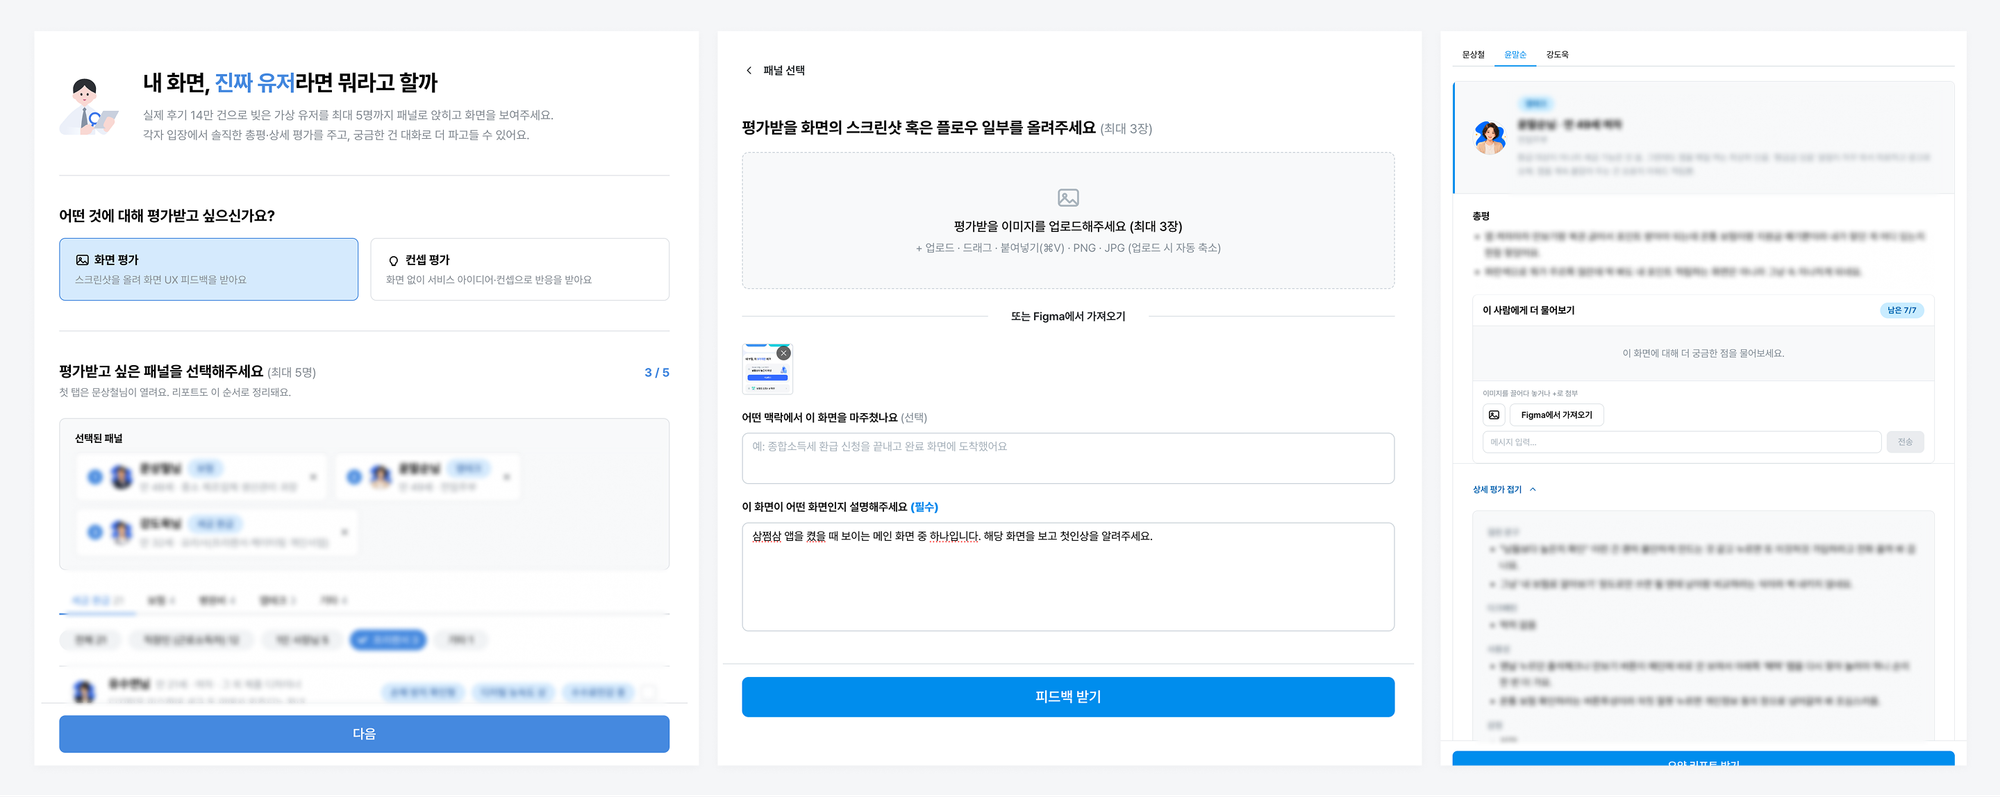
가상 유저 패널에는 실제 리서치에 기반한 페르소나를 두었습니다. 먼저 오픈 소스로 공개된 한국 인구통계 합성 데이터셋(NVIDIA Nemotron-Personas-Korea)[1]을 활용해 나이·직업·지역·가족 구성과 같은 뼈대를 잡았습니다. 그다음에는 삼쩜삼에 누적된 리서치 결과 데이터를 얹어 "이 사람이 서비스 안에서 실제로 어떻게 반응할지"를 구체적으로 채워 나갔습니다. 이때 활용한 것은 조사를 마친 뒤 비식별화해 정리한 리서치 결과 보고서입니다. 인터뷰 녹취나 설문 응답 원본 같은 개인 단위의 데이터는 사용하지 않았습니다.
리서치 결과를 반영하기 위해 우선 저희는 여러 형식으로 흩어져 있던 리서치 자료를 LLM이 읽기 쉬운 위키로 구조화했습니다.[2] 그 다음에는 서비스 이해도·신뢰 태도·예상 마찰 지점 등 핵심 속성을 이 위키에서 추출했습니다. 리서치 결과를 유형별로 묶는 일과 속성을 추출하는 일은 모두 LLM으로 진행했습니다. 정교한 분석 방법을 세우기보다 빠르게 만들어 써 보는 데 초점을 둔 선택이었습니다.
페르소나 프로필은 아래와 같은 JSON 파일로 정리했습니다. 예시는 가상 데이터로 채웠으니 구조만 참고해 주세요.
{
  "segment": "신규 이용자",
  "persona": "소도시에서 반려동물 용품 가게를 하는 34세 자영업자",
  "service_profile": {
    "usage_context": "앱을 켤 때마다 '뭘 잘못 누르면 어쩌지' 하는 걱정이 먼저 온다.",
    "service_comprehension": "낮음. 서비스가 무엇을 해 주는지 개념 자체가 생소"
  }
}
페르소나 프로필을 담은 JSON 파일이 페르소나의 캐논(canon), 즉 설정 원본입니다. 웹 UI·CLI·MCP 서버 중 어디서 호출하든 모두 같은 설정 원본을 읽습니다. 신규 조사 결과가 리서치 위키에 쌓이면 동기화 스크립트가 반영할 내용을 정리합니다. 그러면 AI 모델이 캐논 수정안을 만들어 초안 PR로 올립니다. 캐논의 속성마다 리서치 결과 보고서에서 가져온 행동 근거 문장이 함께 적혀 있어, PM은 수정안이 실제 보고서 내용에 근거하는지 대조해 볼 수 있습니다. 검토를 마치면 PM이 PR을 리뷰 준비(ready-for-review) 상태로 바꿉니다.
프롬프트는 페르소나의 반응 방식·화면 평가 기준·보고서 작성법을 정한 지시문입니다. 프롬프트 파일도 캐논과 같은 폴더에 둡니다.
2. PM과 개발자가 함께 수정할 수 있는 리포지토리
저희는 PM과 개발자가 각자 잘하는 일에 집중할 수 있도록 리포지토리를 설계했습니다. PM은 리서치를 해석해 페르소나 캐논과 프롬프트를 채웁니다. 개발자는 그 내용을 읽어 서비스로 돌리는 코드의 구조를 짭니다. 각자 올린 PR은 CI 검사와 리뷰를 거쳐 리포지토리에 반영됩니다.
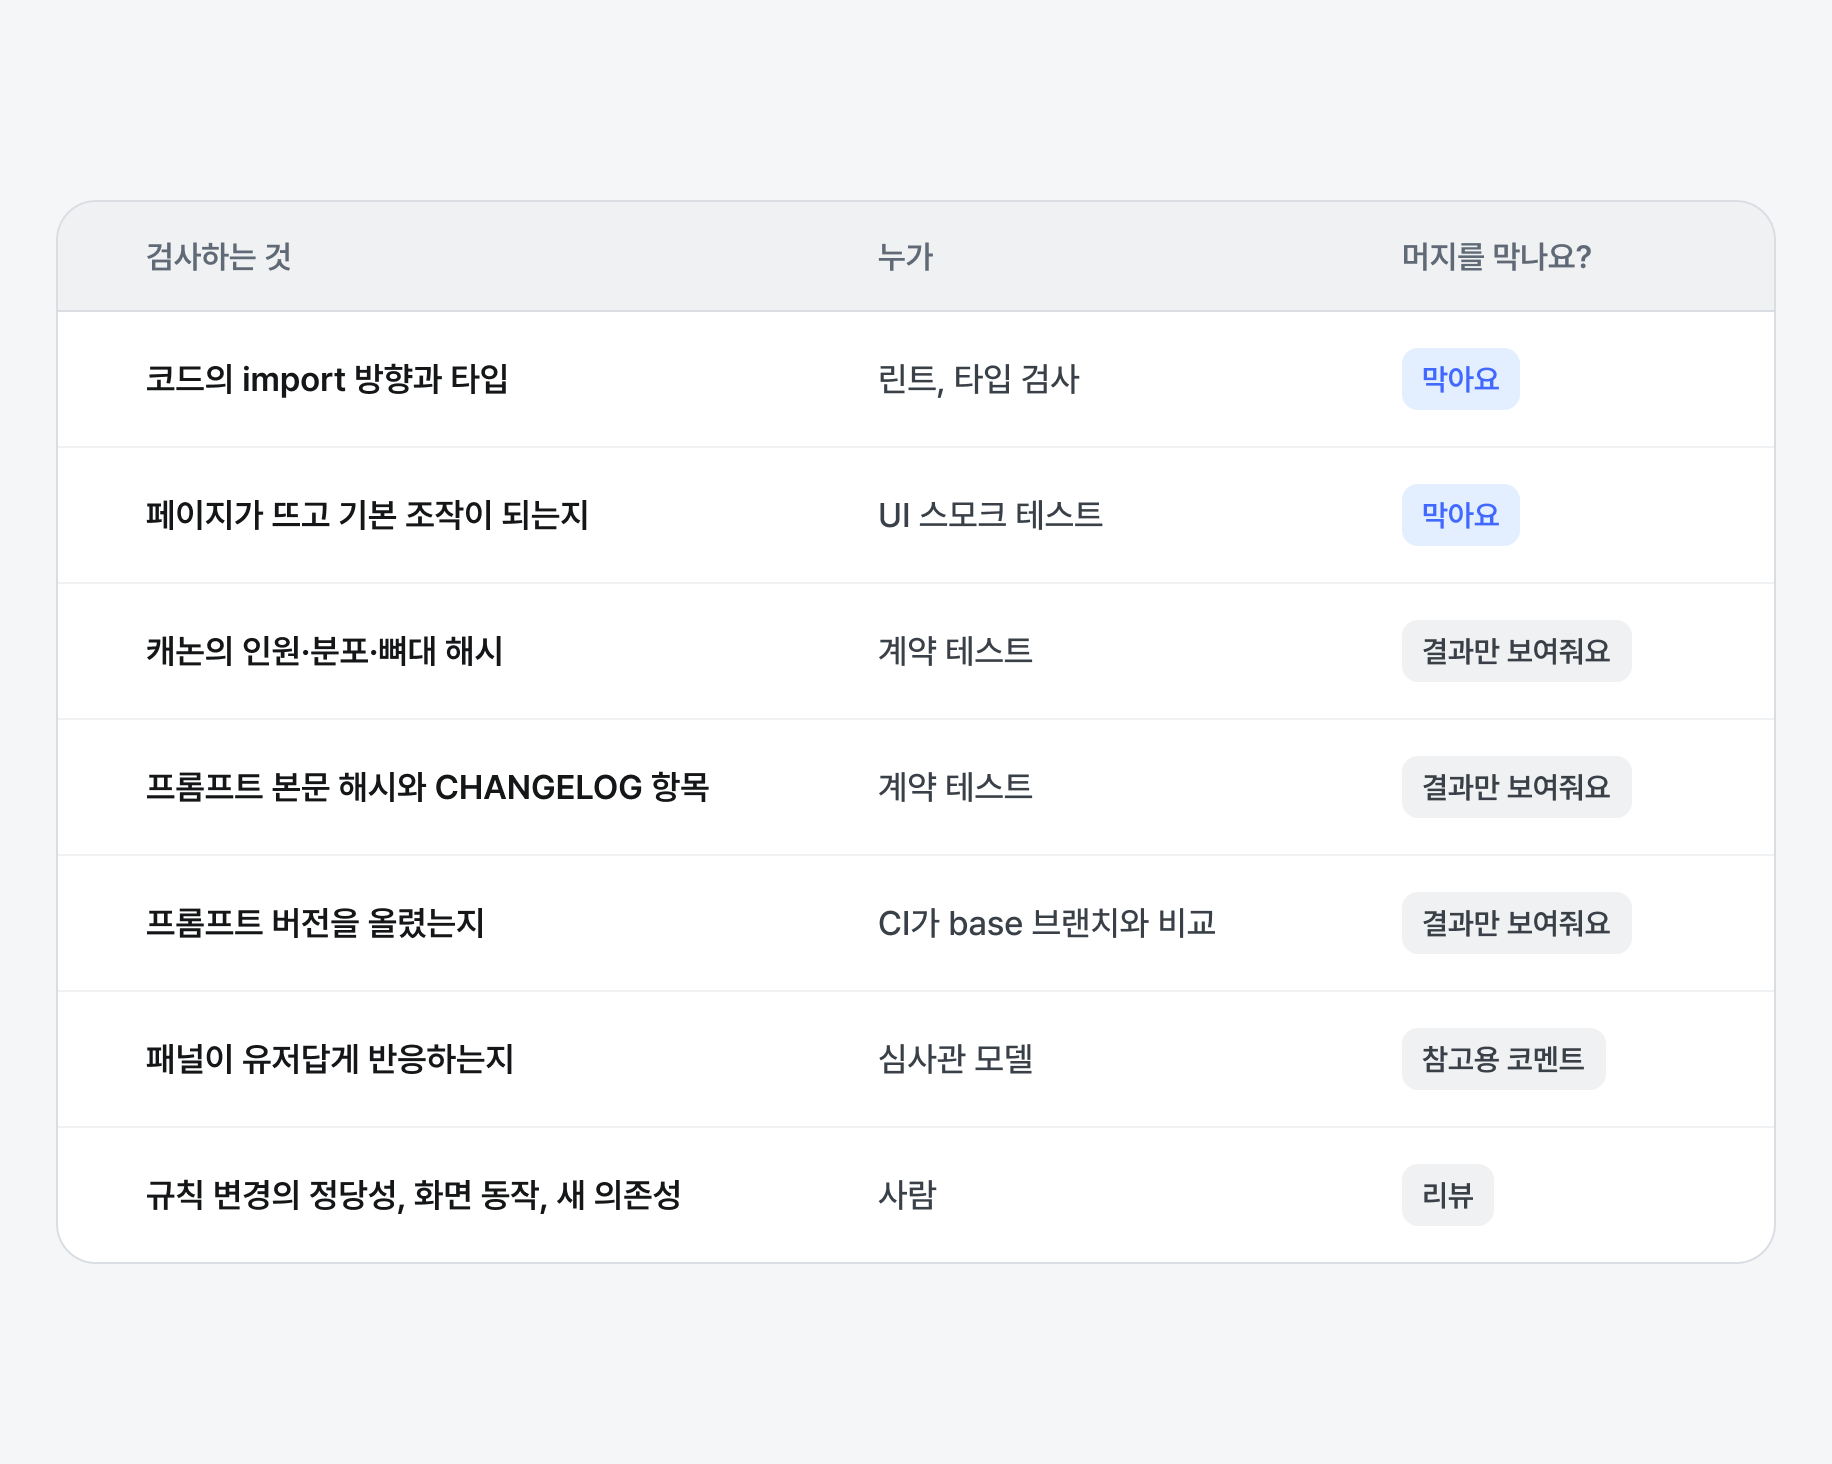
캐논·프롬프트와 서비스 코드에는 다음과 같은 검사 장치를 두었습니다. 린트는 코드의 의존 규칙을 검사합니다. 테스트는 캐논·프롬프트가 정해진 조건을 지키는지 확인합니다. 개발자는 리뷰에서 규칙 변경이 적절한지 검토하고, 화면 동작과 새 의존성을 확인합니다. 검사 항목과 담당·머지 차단 여부는 [표 1]에 정리했습니다.
2-1. PM 파일과 서비스 코드를 나누는 기준
PM 영역과 개발자 영역을 그림 하나로 나타내면 [그림 2]와 같습니다.
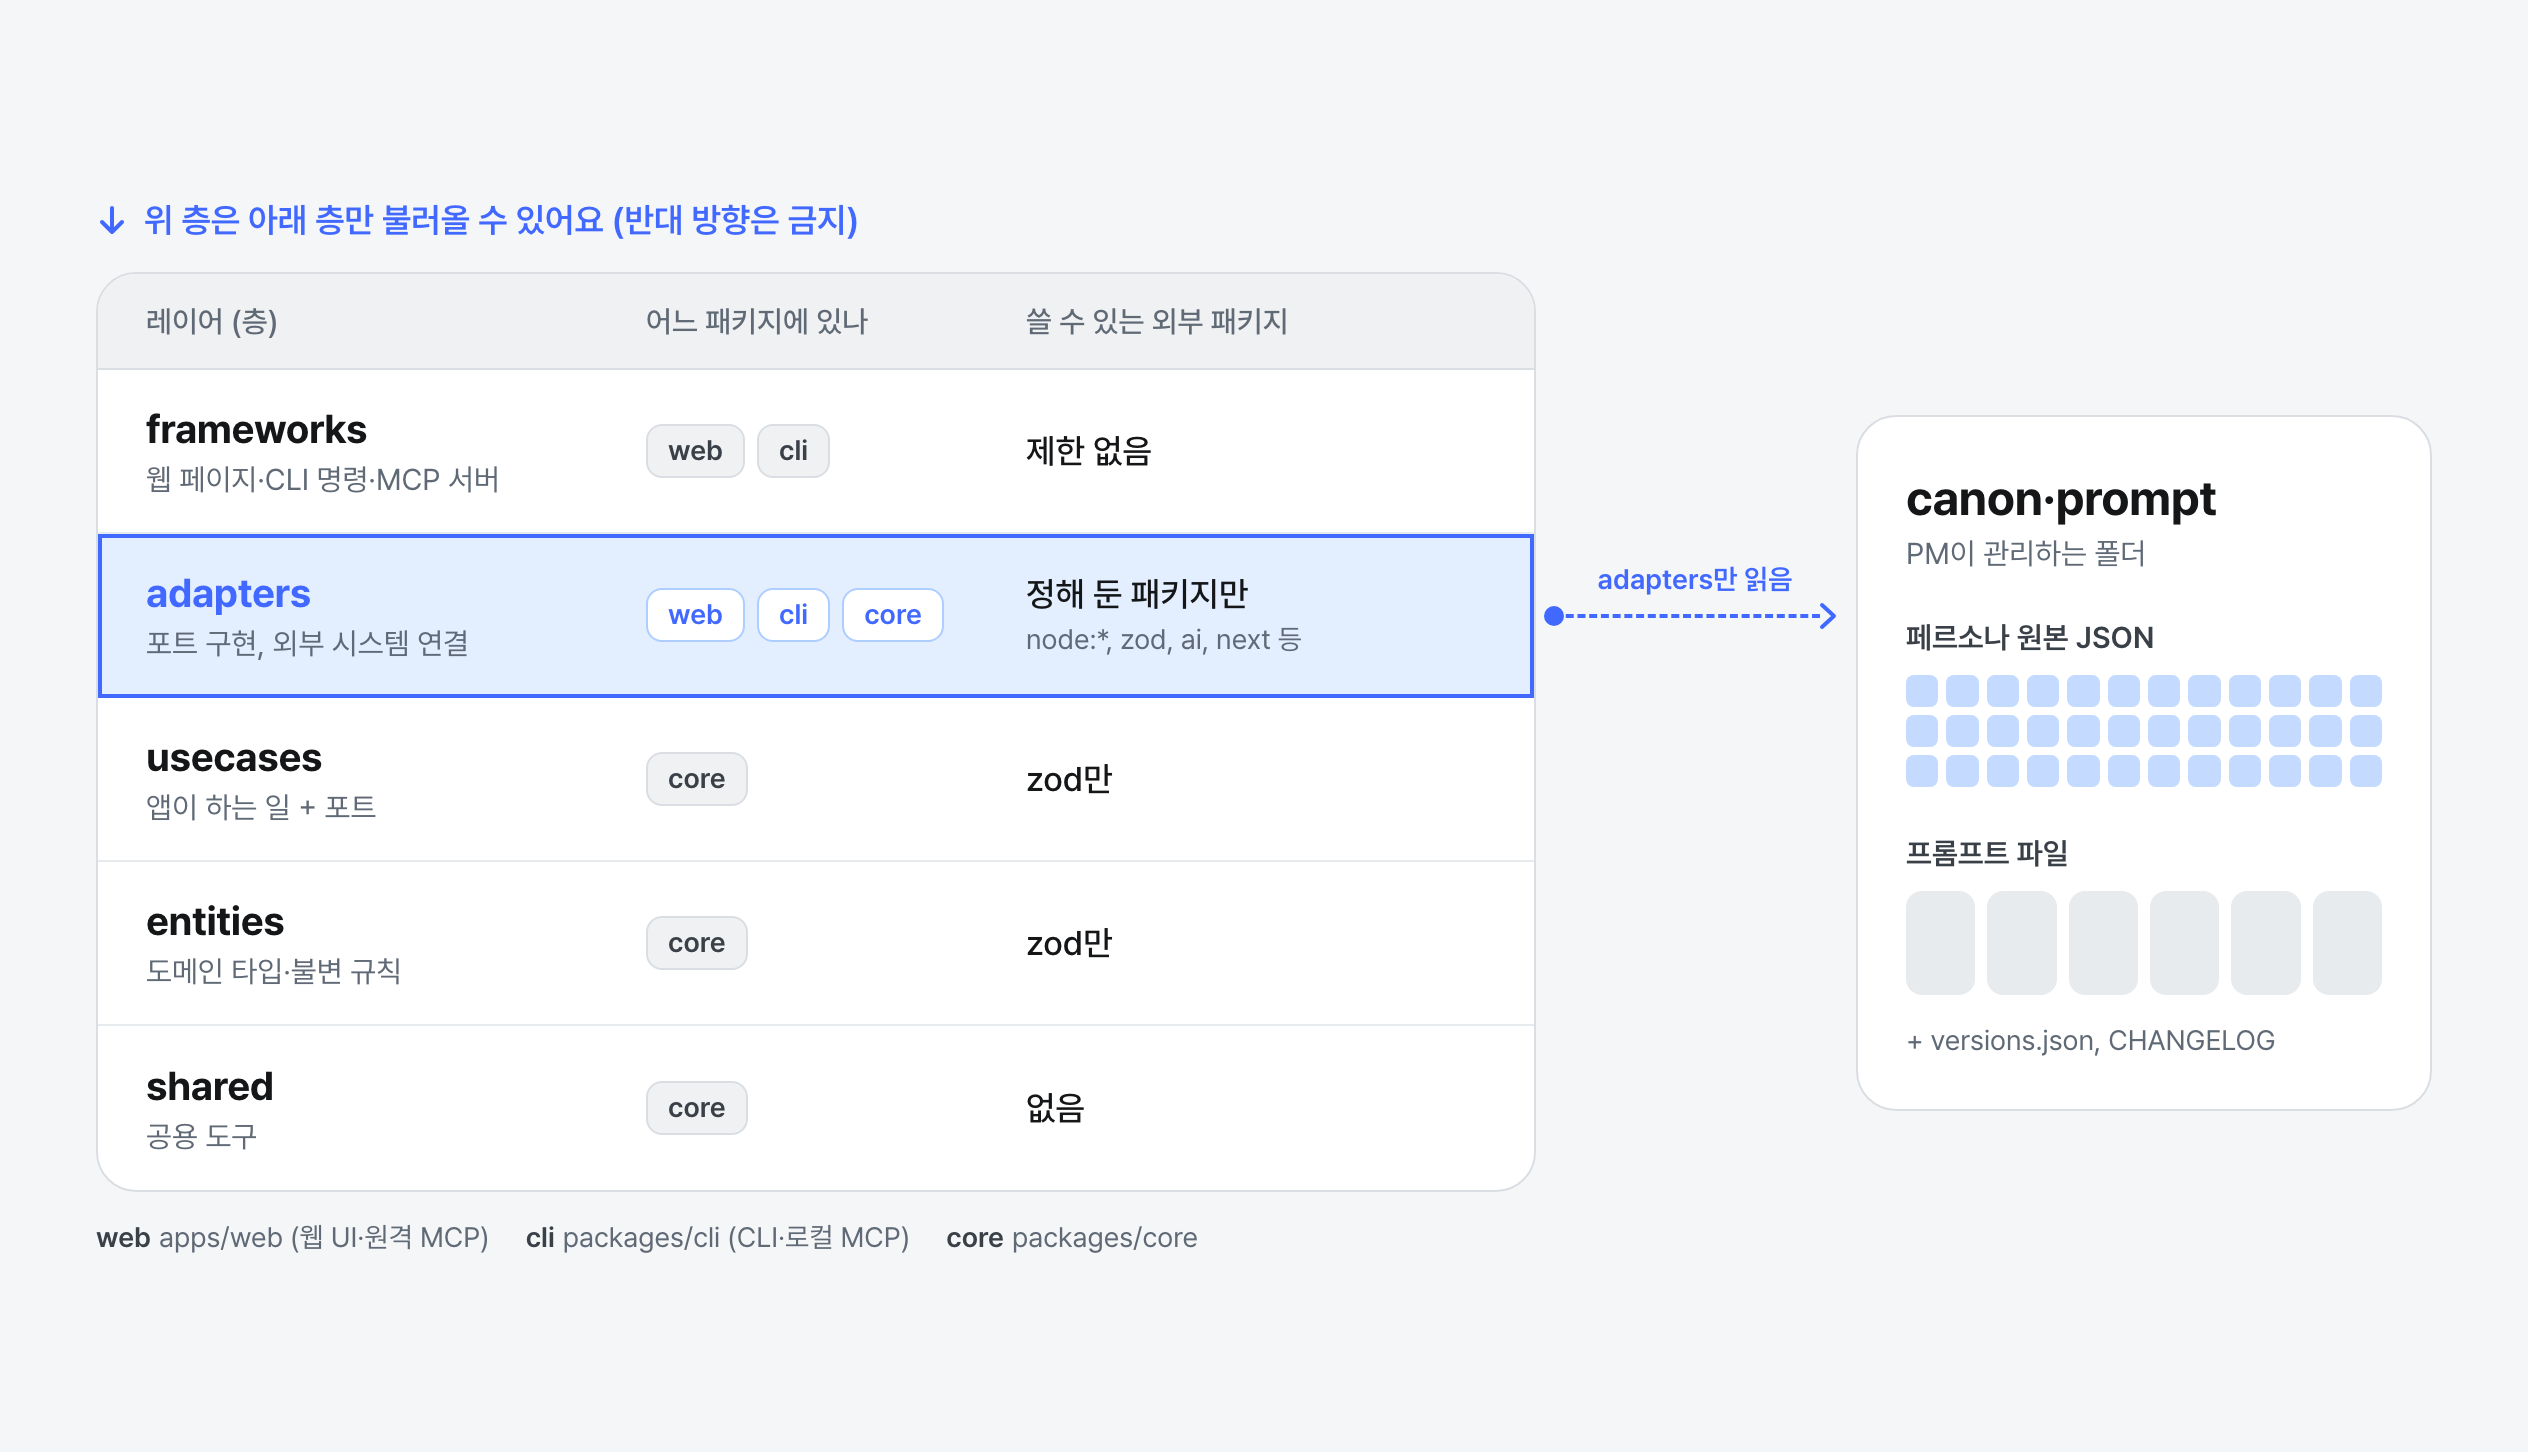
위쪽 레이어는 아래쪽 레이어를 import할 수 있지만, 반대 방향으로는 import할 수 없습니다. 중간 레이어를 건너뛰어도 됩니다. PM 폴더(synthetic-user-feedback/)를 import할 수 있는 레이어는 오로지 adapters 하나뿐입니다.
entities는 데이터 타입과 분류 규칙을 정의하는 레이어입니다. 이 레이어가 캐논 파일의 위치나 읽는 방식에 의존하지 않도록 실제 파일을 읽는 코드는 adapters에 두었습니다.
사실 캐논·프롬프트를 entities에 두는 방법도 고려했습니다. 그런데 캐논·프롬프트 파일들은 PM이 리서치 결과에 따라 수정하는 데이터와 지시문입니다. 개발자가 관리하는 도메인 코드와 구분하기 위해 저희는 코드 레이어 밖인 리포지토리 루트에 PM 폴더를 따로 두었습니다. 이렇게 하면 PM이 관리하는 파일을 한곳에 모을 수 있고, 웹 UI·CLI·MCP 서버도 같은 원본을 읽을 수 있습니다.
frameworks는 캐논을 읽는 어댑터와 프롬프트를 읽는 어댑터를 가져와 조합합니다. 원본을 읽는 경로를 adapters로 모아 두었으므로 PM의 수정이 어디까지 영향을 주는지 따라갈 수 있습니다.
2-2. 의존 규칙을 문서에서 린트로 옮기기
처음부터 이 구조가 완성되어 있진 않았습니다. 사내 AI week에서 MVP를 만들고 나서 리포지토리를 정리하려고 코드를 열었는데, 요청 하나가 도대체 어떤 파일을 거쳐 처리되는지 따라가기 상당히 힘들었죠. 개발자 입장에서는 변경을 이해하지 못한 채 리뷰에서 승인 버튼만 누르게 되진 않을지 걱정됐습니다. 그래서 AI week 발표 이후에 구조를 잡아 나갔습니다.
구조 규칙은 CLAUDE.md와 README에 이미 적혀 있었습니다. 다만 문서만으로는 코드가 그 규칙을 지키는지 자동으로 검사할 수 없었습니다. 그래서 개발자는 ESLint 10의 flat config에 eslint-plugin-boundaries을 적용해 린트가 의존 규칙 위반을 검사하도록 했습니다.
2-2-1. import 규칙과 외부 패키지 제한
아래는 entities와 usecases에 적용한 규칙입니다. from에는 검사할 코드가 속한 레이어를 지정하고, allow.to에는 그 레이어에서 import를 허용할 대상을 지정합니다. 기본 설정이 default: 'disallow'이므로 allow.to에 명시하지 않은 대상을 import하면 린트 오류가 납니다. 예시에서는 폴더를 레이어에 대응시키는 elements 설정과 이 기본 설정은 생략했습니다.
// entities가 import할 수 있는 층: shared, entities
{ from: { element: { type: 'entities' } },
  allow: { to: { element: { types: { anyOf: ['shared', 'entities'] } } } } },
// usecases가 import할 수 있는 층: shared, entities, usecases
{ from: { element: { type: 'usecases' } },
  allow: { to: { element: { types: { anyOf: ['shared', 'entities', 'usecases'] } } } } },
// 두 층이 쓸 수 있는 외부 패키지: zod 하나. 나머지는 포트로 돌린다.
{ from: { element: { types: { anyOf: ['entities', 'usecases'] } } },
  allow: { to: { module: { origin: 'external', source: 'zod' } } },
  message: 'entities·usecases가 쓸 수 있는 외부 패키지는 zod뿐이에요. 나머지는 usecases의 포트로 뒤집어주세요.' },
entities와 usecases에서 사용할 수 있는 외부 패키지는 zod로 제한했습니다. 다른 외부 패키지가 필요한 기능은 adapters에서 구현하고, usecases에 정의한 인터페이스로 호출합니다. 이 인터페이스를 포트라고 합니다([그림 2]).
작은 사내 툴에 레이어와 포트까지 둔 이유는 진입점이 세 개이기 때문입니다. 리포지토리는 모노레포입니다. 웹 UI와 원격 MCP 서버는 apps/web에 있습니다. CLI와 로컬 MCP 서버는 packages/cli에 있습니다. 세 진입점이 함께 쓰는 shared·entities·usecases와 캐논·프롬프트를 읽는 어댑터는 packages/core로 분리했습니다. 그래서 [그림 2]의 frameworks는 웹 페이지·CLI 명령·MCP 서버로 나뉘어 있지만, 캐논을 읽는 코드는 core에 하나만 있습니다. 진입점마다 캐논을 따로 읽었다면 한쪽만 고쳐져 같은 페르소나가 진입점에 따라 다르게 답하는 일이 생기기 쉬웠을 겁니다.
2-2-2. 에이전트를 위한 린트 오류 메시지
에이전트가 규칙에 막혔을 때 다음 행동을 정할 수 있도록 message를 썼습니다. 그 순간 에이전트가 읽는 안내는 이 한 줄뿐입니다. 금지 사항만 적으면 에이전트는 해당 규칙을 검사하지 않도록 설정하거나 허용 범위를 넓히는 쪽으로 해결하려 할 수 있습니다. 그래서 포트로 외부 시스템을 연결하라는 대안을 메시지에 명시했습니다. 문서에 있던 안내를 린트 오류 메시지로 옮겨 에이전트가 바로 읽고 따를 수 있게 했습니다. 구조 규칙도 설정 파일 하나에 모아 전체 의존 관계를 한눈에 확인할 수 있게 했습니다.
2-2-3. 검사 예외와 설정 변경
코드 주석으로는 린트 규칙에 예외를 두지 못하게 했습니다. 코드 구역에서 어느 레이어에도 속하지 않는 파일은 린트 오류로 처리합니다.
linterOptions: { noInlineConfig: true },           // 주석 한 줄로 룰을 끄지 못한다
rules: { 'boundaries/no-unknown-files': 'error' }, // 코드 구역 안에 어느 층에도 안 속하는 새 폴더를 만들지 못한다
특정 파일을 린트 규칙의 적용 대상에서 제외하려면 설정 파일에 대상 파일·규칙·제외 이유를 명시해야 합니다. 변경 내용은 PR diff에 남습니다.
layerBoundaries.test.ts는 금지된 import를 넣은 테스트용 파일을 실제 린트 설정으로 검사합니다. 예상한 오류가 발생해야 테스트가 통과합니다. 설정에서 해당 규칙을 삭제해 오류가 나지 않으면 테스트가 실패합니다.
2-2-4. 코드 작성 단계의 린트 검사
새 코드를 추가할 때도 이 의존 규칙을 따르도록 설정했습니다. 에이전트는 파일을 둘 레이어와 import할 대상을 정하고, 허용되지 않은 import는 린트 오류를 보고 수정합니다. 의존 규칙 위반을 코드 작성 단계에서 확인하니 리뷰에서 import를 일일이 검사할 필요가 줄었습니다. 변경된 코드의 동작과 영향 범위를 검토할 때, 파일의 역할과 의존 방향을 기준으로 관련 코드를 따라갈 수도 있게 되었죠.
2-3. 캐논과 프롬프트의 변경을 확인하는 두 가지 검사
PM 폴더에는 페르소나 캐논 JSON과 프롬프트 파일을 두었습니다. 웹 UI·CLI·MCP 어디에서 패널을 호출하든 같은 파일을 읽어 응답을 생성합니다. 프롬프트를 고치면 버전을 올리고 CHANGELOG에 변경 이유와 검증 결과를 남깁니다.
예를 들어 저희는 ‘페르소나가 과제를 자기 사정에 맞춰 시도하도록’ 지시문을 고친 적이 있습니다. 이전 버전의 패널이 놓치던 UI 결함을 수정 후에는 짚어냈고, 이 결과를 기록한 뒤 배포했습니다.
이런 변경은 두 가지 검사로 확인합니다. 테스트는 데이터와 버전 기록이 정해진 조건을 지키는지 확인하고, 모델 기반 검증(LLM-as-a-Judge)은 실제 패널 응답을 평가합니다. 두 검사는 별도의 CI 워크플로에서 실행됩니다.
2-3-1. 테스트: 데이터와 버전 기록이 조건을 지키는가
LLM을 호출하지 않는 테스트는 수 초 안에 끝나며, 같은 입력에 항상 같은 결과를 냅니다. 검사 항목은 다음과 같습니다.
- 캐논 무결성: 페르소나 총원과 삼쩜삼 전용 프로필 보유 인원을 기준선과 비교하고, UUID 중복을 확인합니다. 이름·세그먼트·나이·성별의 해시도 대조해 이전 캐논 사본이 섞였는지 검사합니다. 행동 근거 문장은 해시에서 제외해 PM이 자유롭게 수정할 수 있도록 했습니다.
- 분포와 매핑: 서비스 그룹별·세금 소분류별 인원이 기준선과 일치하는지, 검색 필터 매핑에 누락된 페르소나가 있는지 확인합니다.
- 용어 대응표: 리서치 용어와 데이터셋 용어를 잇는 문서는 원본 JSON에서 자동 생성합니다. 문서를 직접 수정해 원본과 달라지면 테스트가 실패합니다.
- 프롬프트 버전: 모델에 들어가는 프롬프트 본문의 SHA-256 해시가
versions.json과 일치하는지, 현재 버전의 변경 기록이CHANGELOG에 있는지 확인합니다.
프롬프트 버전의 경우에는 추가 검사가 필요합니다. 위 테스트는 현재 파일끼리의 일치 여부만 확인하므로, 본문과 해시를 함께 고치면 버전을 그대로 둬도 통과합니다. 그래서 CI는 pnpm test 뒤에 pnpm prompt-version:check를 실행합니다. PR의 base 브랜치와 비교해 본문이 바뀌었는데 버전이 그대로라면 테스트가 실패하도록 했습니다.
2-3-2. 모델 기반 검증: 실제 응답이 기대를 충족하는가
모델 기반 검증은 패널을 직접 호출하고, 심사관 모델이 응답을 채점합니다. 여기서는 알려진 이슈의 재현과 응답 규칙 준수를 확인합니다.
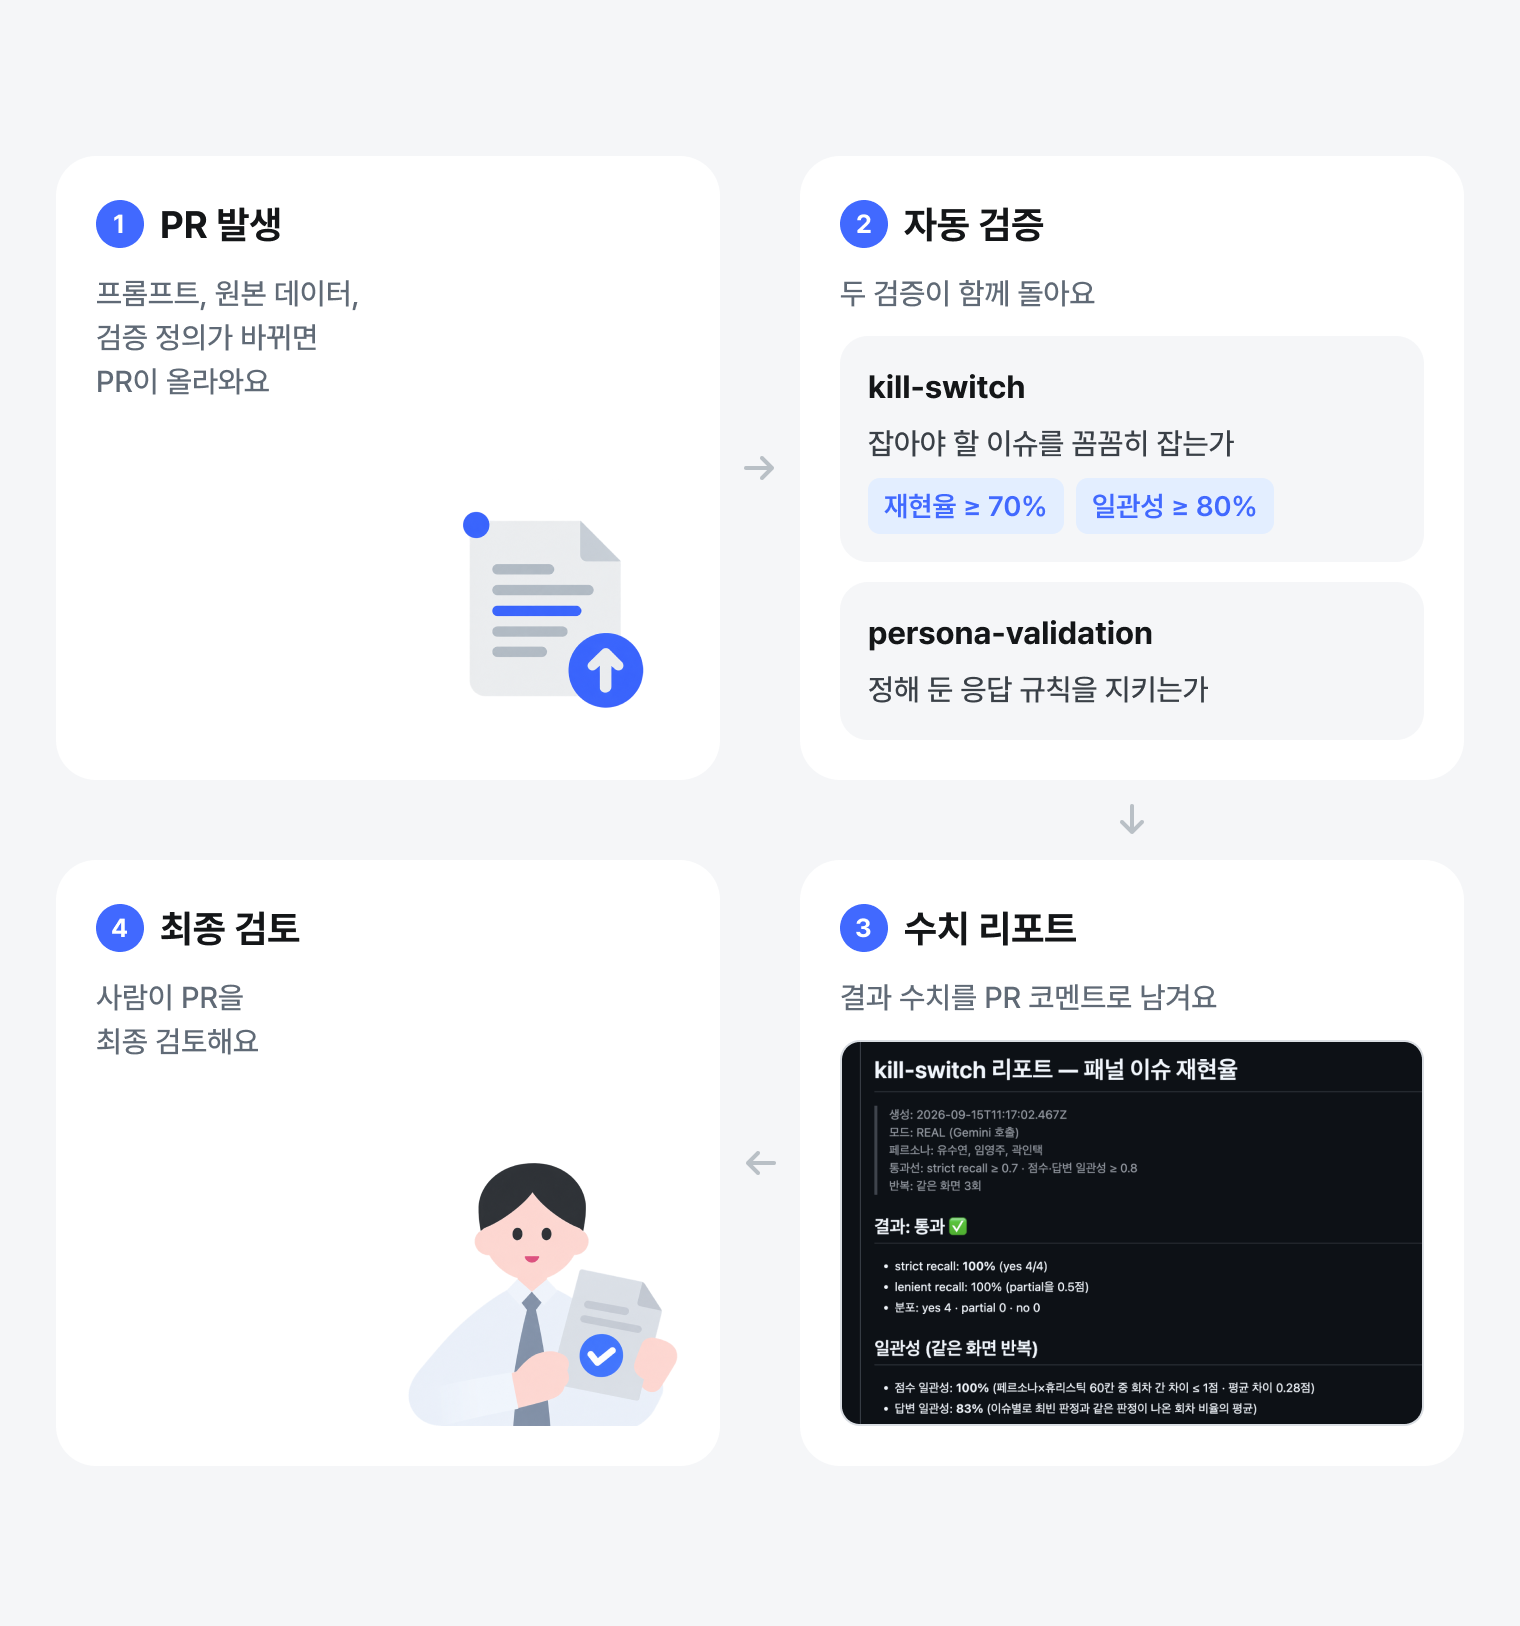
kill-switch는 패널이 알려진 이슈를 다시 찾아내는지 확인합니다. 실제 유저 불만이 컸던 화면과 이슈를 골든셋(정답을 미리 정해 둔 평가 데이터)으로 두고, 같은 화면을 3회 보여 줍니다. 심사관은 이슈마다 yes·partial·no로 판정하며, 결과는 세 지표로 확인합니다.
- 재현율: 이슈별로 3회 중 가장 많이 나온 판정이 yes인 비율입니다. 동률이면 낮은 판정을 택합니다.
- 점수 일관성: 사용성 평가 항목별 점수(10점 만점)가 회차 사이에 1점 이내로 움직인 비율입니다.
- 답변 일관성: 이슈마다 같은 판정이 나온 회차의 비율입니다.
합격하려면 재현율 70% 이상·두 일관성 80% 이상·채점 실패 0건을 모두 만족해야 합니다. 다만 기존 이슈를 놓치지 않는지 보는 회귀 검사이므로, 높은 일관성이 정확도를 보장하지는 않습니다. 골든셋도 아직 작아 이슈 몇 개에 따라 재현율이 크게 달라질 수 있어서, 리서치에서 새로 확인된 이슈를 계속 추가하고 보완할 계획입니다.
persona-validation은 시안과 질문에 맞게 응답하는지 확인합니다. {홍길동}이나 010-0000-0000 같은 템플릿 변수·더미 데이터를 오류로 지적하거나, 여러 질문 중 일부에만 답하면 규칙 위반으로 판정합니다. 검증 전에는 사람이 채점한 예시를 심사관도 똑같이 채점하는지 확인하는 ‘심사관 보정’을 진행합니다. 하나라도 틀리면 검증 전체를 미달로 처리합니다.
모델 기반 검증은 프롬프트·캐논·검증 정의가 바뀐 PR에서만 실행합니다. persona-validation은 변경된 페르소나를 우선 검사하고, 나머지 표본은 세그먼트별로 돌아가며 채웁니다. 결과는 PR 코멘트로 남기며, 현재는 머지를 자동으로 차단하지 않고 담당자가 최종 검토합니다([그림 3]). 데이터가 더 쌓이면 검증 로직을 개선하고, 결과에 따라 머지를 차단하는 방식도 도입할 계획입니다.
2-4. 실제 변경에서 드러난 자동 검사와 개발자 리뷰의 역할
PM이 올린 PR은 [표 1]의 검사를 CI에서 먼저 받습니다. 에이전트는 로컬에서 타입 검사·테스트·빌드를 실행하고 화면 스크린샷을 찍습니다. PM은 단계마다 그 결과를 보고 제품 동작과 다음 작업을 결정합니다.
CI를 통과한 PR을 리뷰할 때 개발자는 먼저 린트 설정 파일과 테스트가 바뀌었는지 확인합니다. 변경 사항을 검사하는 기준 자체가 달라졌는지 보기 위해서입니다. 그다음 작업 기록에서 변경 이유와 검증 결과를 읽고, 화면 동작이나 데이터 저장처럼 추가로 확인할 부분을 살펴봅니다. 디자인 시스템 전환과 DB 스키마 추가 사례에서 이 과정을 볼 수 있습니다.
2-4-1. Mantine·Panda CSS로 디자인 시스템을 바꾼 사례
PM이 디자인 시스템을 Mantine과 Panda CSS로 바꾸는 PR을 올렸습니다. 추가된 줄만 4,000줄에 가까웠고 바뀐 파일은 33개였습니다. CI 테스트는 통과했고, 의존 방향도 린트가 검사했습니다.
개발자가 먼저 살펴본 것은 린트 설정에서 바뀐 14줄이었습니다. Panda CSS가 생성하는 폴더(styled-system/)를 frameworks 레이어에서만 import하도록 허용하고, 그 폴더를 린트 대상에서 제외한 설정이었습니다. 에이전트는 구현 중 import가 린트에 막히자 허용 범위를 좁게 지정했고, 작업 기록에 그 이유를 남겼습니다. 개발자는 새로 허용한 의존성과 검사에서 제외한 폴더가 적절한지 검토했습니다.
구조 규칙의 변경을 확인한 뒤에는 화면 동작과 새 의존성에 집중했습니다. 머지 전에는 개발자가 Panda CSS 설정을 엄격 모드(토큰에 없는 값을 쓰면 오류)로 바꾸고, 그에 맞춰 css() 호출을 수정했습니다. PM은 신규 디자인 시스템 도입이라는 제품 결정을 맡았습니다. 에이전트는 구현을 맡았고, 개발자는 검토와 마무리 수정을 맡았습니다.
2-4-2. Supabase에 테이블을 추가한 사례
PM은 웹 UI·CLI·MCP에서 받은 질문·가상 유저 페르소나 응답·평가 결과를 분석하기 위해 Supabase에 테이블을 추가하는 작업도 에이전트와 함께 진행했습니다. DB 접근 코드는 adapters에 모았습니다.
이 작업에서 린트는 DB 의존성이 허용된 레이어에만 들어가는지 확인했습니다. 테스트는 저장할 데이터가 올바르게 구성되는지 검사했습니다. 실제 DB 검증에서는 스키마 적용과 초기 데이터 입력 순서, 각 경로에서 데이터가 쌓이는지를 별도로 확인하도록 했습니다. 코드 검사를 통과한 뒤에도 실제 저장 동작을 확인하는 절차가 필요했습니다.
위 두 사례를 보면, 자동 검사와 개발자 리뷰가 맡은 역할은 분명합니다. 자동 검사는 변경이 정해진 규칙을 지키는지 확인했고, 개발자는 리뷰에서 그 규칙을 바꾼 이유가 적절한지 판단 후 변경에 맞는 추가 검증을 확인했습니다. 함께 수정할 수 있는 범위를 넓히려면, 무엇을 자동으로 검사하고 무엇을 사람이 확인할지도 함께 정해야 합니다.
3. 다른 팀에 적용한다면
저희 구조를 그림 하나로 요약하면 [그림 4]와 같습니다. 코드 사이의 화살표는 의존 방향입니다.
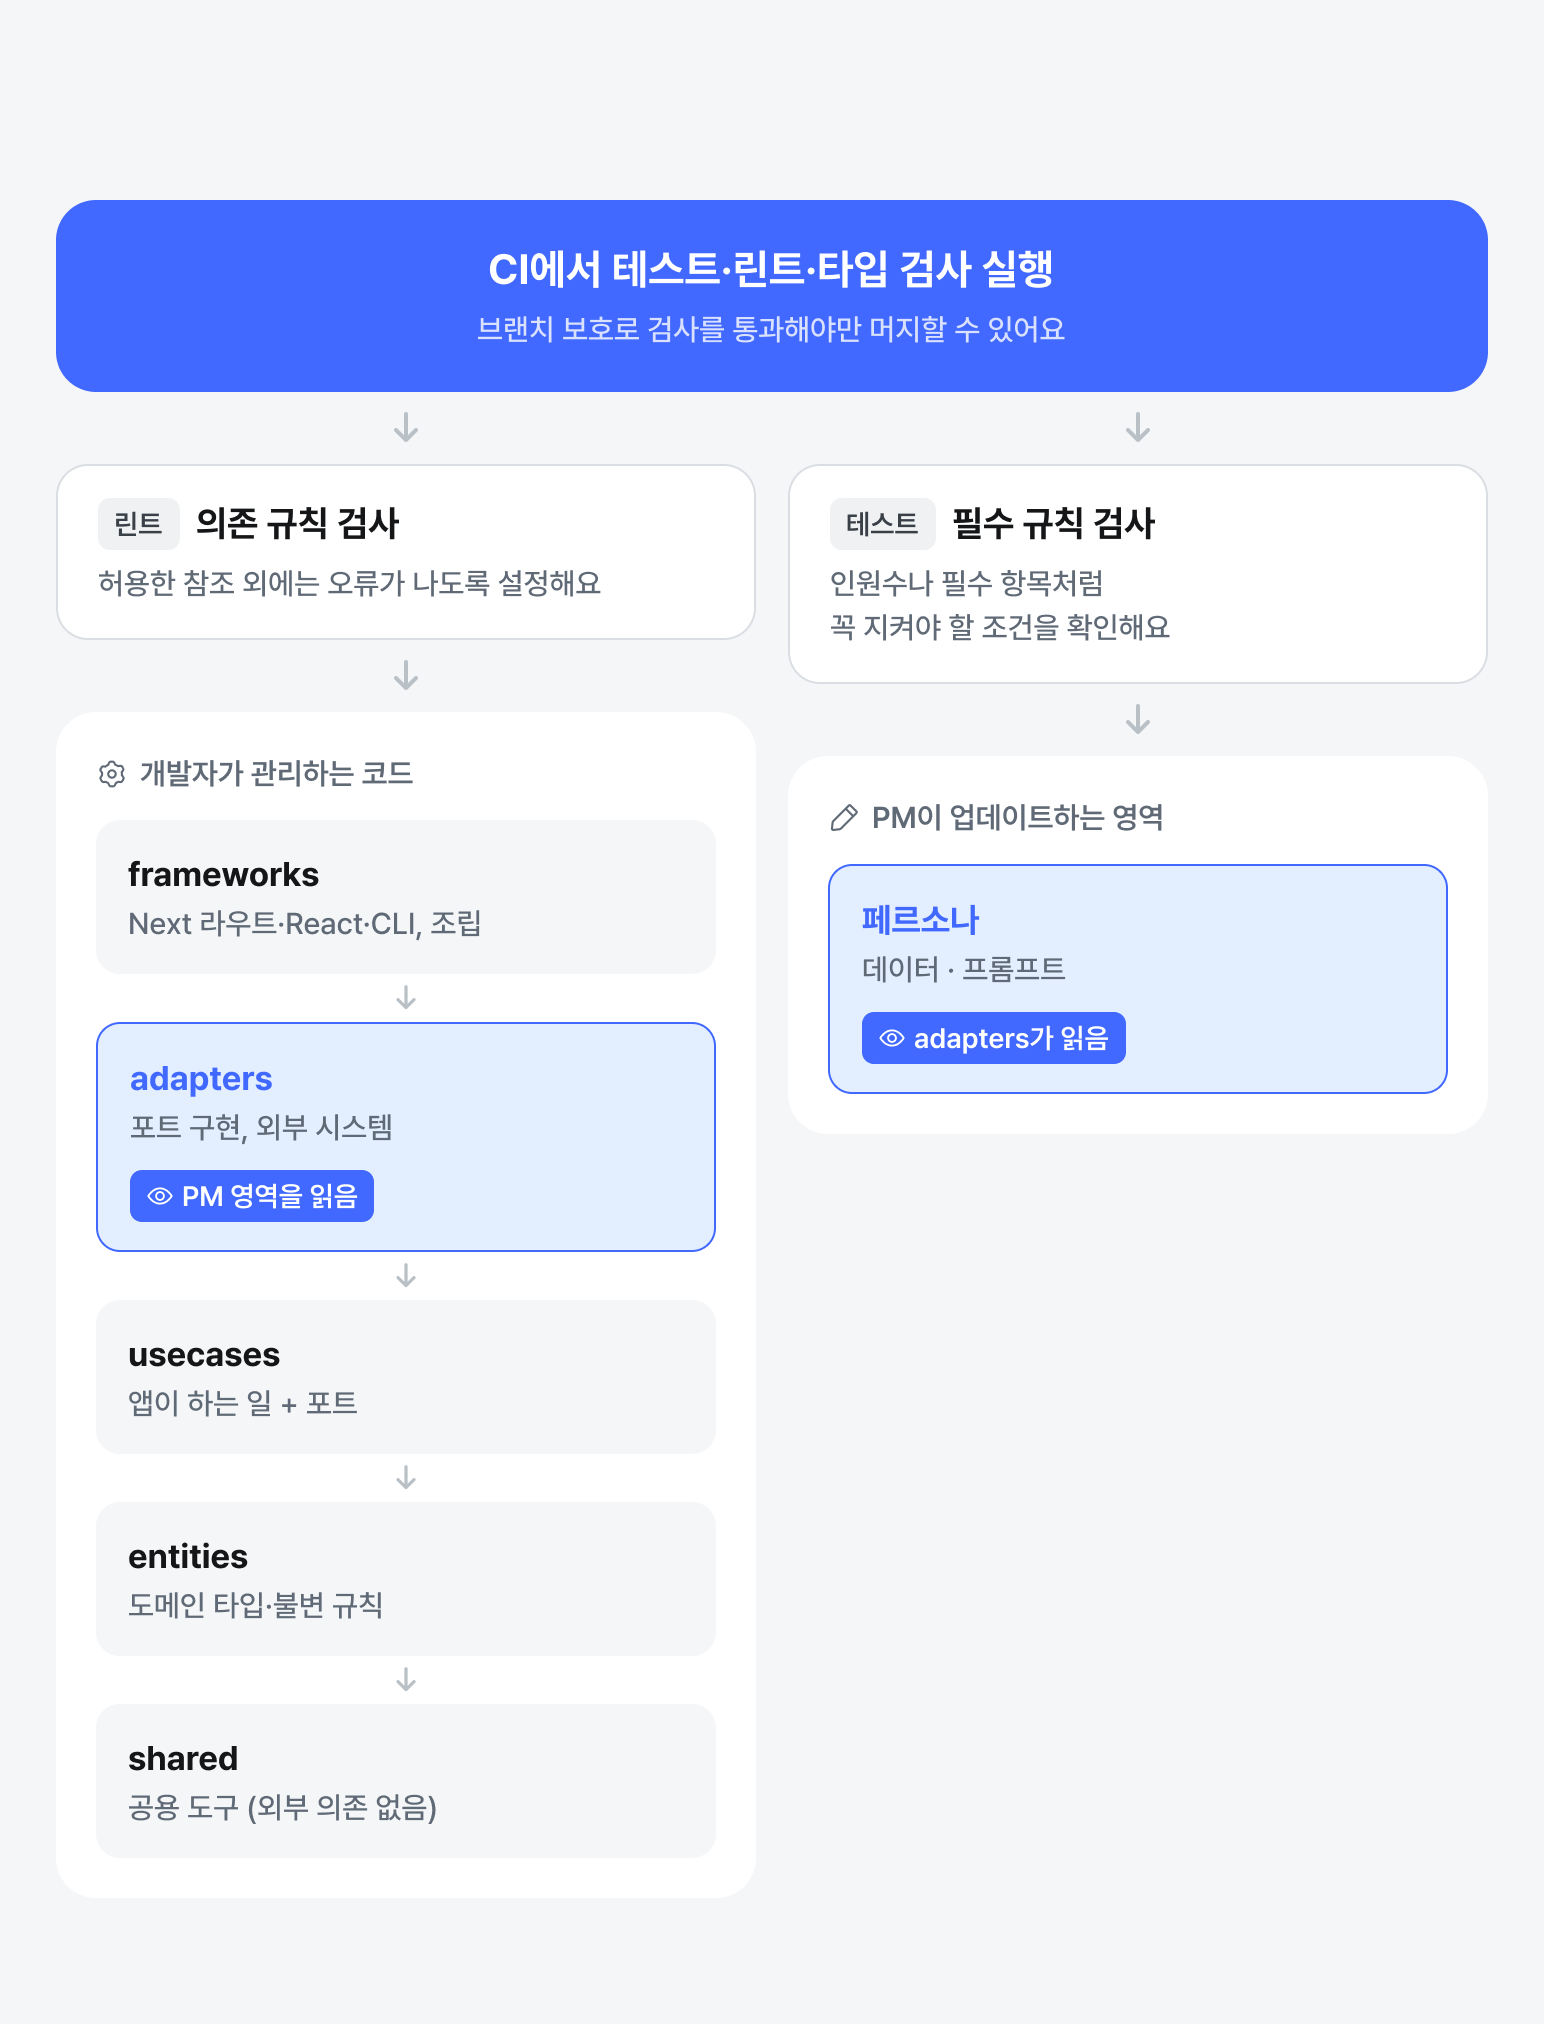
이 구조는 특히 콘텐츠와 설정이 곧 제품의 동작이 되는 도메인에서 잘 맞습니다. 가상 유저 패널은 페르소나 데이터와 프롬프트가 곧 서비스 로직이었기 때문에, PM이 관리할 파일과 서비스 코드를 깔끔하게 나눌 수 있었습니다. 예를 들어 다음과 같은 영역이라면 같은 방식을 적용해 볼 만합니다.
- 프롬프트가 응답 품질을 좌우하는 LLM 기능: 상담 챗봇의 응답 지침, 문서 요약·분류 기준
- 규칙표로 동작이 정해지는 기능: 지원금·혜택의 자격 조건, 요금제·수수료 정책
- 문구와 템플릿이 핵심인 기능: 온보딩 안내 문구·푸시·알림 메시지 템플릿·설문 문항
비슷한 구조를 만들려는 팀이 있다면 다음 순서로 만들 것을 제안합니다.
- PM이 직접 관리할 파일을 정합니다. 데이터와 프롬프트는 별도 폴더에 두고, 서비스가 그 파일을 직접 읽게 합니다.
- 코드의 역할과 의존 방향을 정합니다. PM의 파일을 읽는 코드는 한 레이어에 모읍니다.
- 의존 규칙을 린트로 검사합니다. 허용한 import 외에는 오류가 나게 하고, 금지된 import가 정말 막히는지 확인하는 테스트도 둡니다. 검사에서 제외할 파일과 규칙이 있다면 설정 파일에 대상과 이유를 남깁니다.
- PM 파일의 필수 조건을 테스트로 검사합니다. 인원수처럼 유지해야 할 조건만 정하고, 그 안에서는 자유롭게 고칠 수 있게 합니다.
- CI에서 검사하고, 통과해야 머지되게 합니다. 린트·타입 검사·테스트를 CI에서 돌리고 브랜치 보호(branch protection)의 필수 검사로 지정합니다. 저희는 린트·타입 검사·UI 스모크 테스트(페이지가 뜨고 기본 조작이 되는지 보는 Playwright 테스트)까지 필수로 지정했습니다.
(참고: 이번 '가상 유저 패널'의 경우, 캐논과 프롬프트를 검증하는 테스트는 아직 결과만 표시합니다. 캐논·프롬프트와 관련된 파일이 업데이트 된 PR에서만 실행되는 검증 테스트인데, 필수 검사로 지정하면 캐논·프롬프트 파일 업데이트가 발생 안 했을 때의 모든 PR들이 대기 상태로 남아 머지가 막히게 되기 때문입니다.)
4. 마무리하며
돌아보면 PM과 개발자가 함께 커밋하기 위한 준비는 각자가 고칠 파일을 나누고, 변경을 확인할 방법을 마련하는 일이었습니다. PM이 관리하는 파일의 조건은 테스트로, 코드의 의존 방향은 린트로 검사했습니다. 그렇게 PM과 개발자의 PR이 같은 검사를 받으며 하나의 리포지토리에 쌓였습니다.
레이어를 나누고 린트와 테스트를 만드는 건 개발자라면 익숙한 일입니다. 저희는 이 방식을 응용해 PM과 개발자가 함께 커밋하고 리뷰하는 프로세스를 설계했습니다. 덕분에 PM도 안정적으로 기여할 수 있는 리포지토리를 즐겁게 만들어 나갈 수 있었습니다. 여러분의 팀에서도 비개발자가 직접 고쳐 보고 싶은 파일 하나와 그 변경을 확인할 테스트 하나부터 시작해 보세요.
nvidia/Nemotron-Personas-Korea, Hugging Face. ↩︎
위키의 틀은 안드레이 카파시(Andrej Karpathy)의 LLM Wiki 개념과, 이를 표준 포맷으로 정리한 Google Cloud의 Open Knowledge Format(OKF)을 차용했습니다. ↩︎
글 | 한상욱, 안치은
본 콘텐츠의 저작권은 (주)자비스앤빌런즈에게 있으며, 본 콘텐츠에 대한 무단 전재 및 재배포를 금지합니다